

中国AI最有权力的数据掌舵人:8家公司,11位核心负责人
Z Finance2026年10月28日 22:11:29 Updated 2026年10月29日 12:05:14
2026 年秋天,大模型行业水面之下同时发生了两件事。
第一件事发生在创投市场。9 月中旬,成立不到一年的中国 AI 评测与合成数据初创公司 UniPat AI 被曝即将完成约 3 亿美元融资,由阿里拟领投,腾讯、红杉中国等跟投,估值飙至 25 亿美元。创始人李宽是一名 90 后港科大博士,去年还在阿里通义实验室做后训练与数据合成。而在 UniPat 身后,前字节 Seed 成员创办的智能知识、前 MiniMax 骨干创办的 Copula Lab、以及获红杉、BAI 与鼎晖连轮押注的原壤智能都在今年密集浮出水面。
第二件事发生在大厂与头部模型公司内部:随着数据战略从内部自给全面转向外采与合成,掌管 AI 数据的一号位正在经历一轮密集换防与集权。
短短两个月内,几家大厂的数据大盘接连易主:8 月,字节跳动把 AI 数据升格为与 Seed、Flow、抖音平行的公司级一级部门「AI 数据与安全」,统揽全集团跨模态数据的寻源外采与评测交付,原负责人傅越离职创业,由曾执掌 TikTok 全球直播与平台责任的王赢磊接盘。仅隔一周,Seed 基模体系又新设 Pretrain Data 部门,交由老搜索人李成刚统管。
9 月底,腾讯二十年大数据老将刘煜宏卸任 AI Data 部负责人,由首席 AI 科学家姚顺雨直接兼任。更早的 7 月,小红书挖来前 DeepSeek 早期核心成员陈官厅出任预训练数据负责人。阿里则在 9 月云栖大会上亮出了训练数据、数据生态、评测与具身数据四位细分掌舵人。
外部,数据公司估值飙升;内部,数据负责人频繁换防。两种变化指向同一个事实:随着公开互联网语料日益耗尽,数据正从业务流量的副产品,变为决定模型能力上限的核心基础设施。
而掌舵数据的人,也随之走向 AI 舞台的中央。
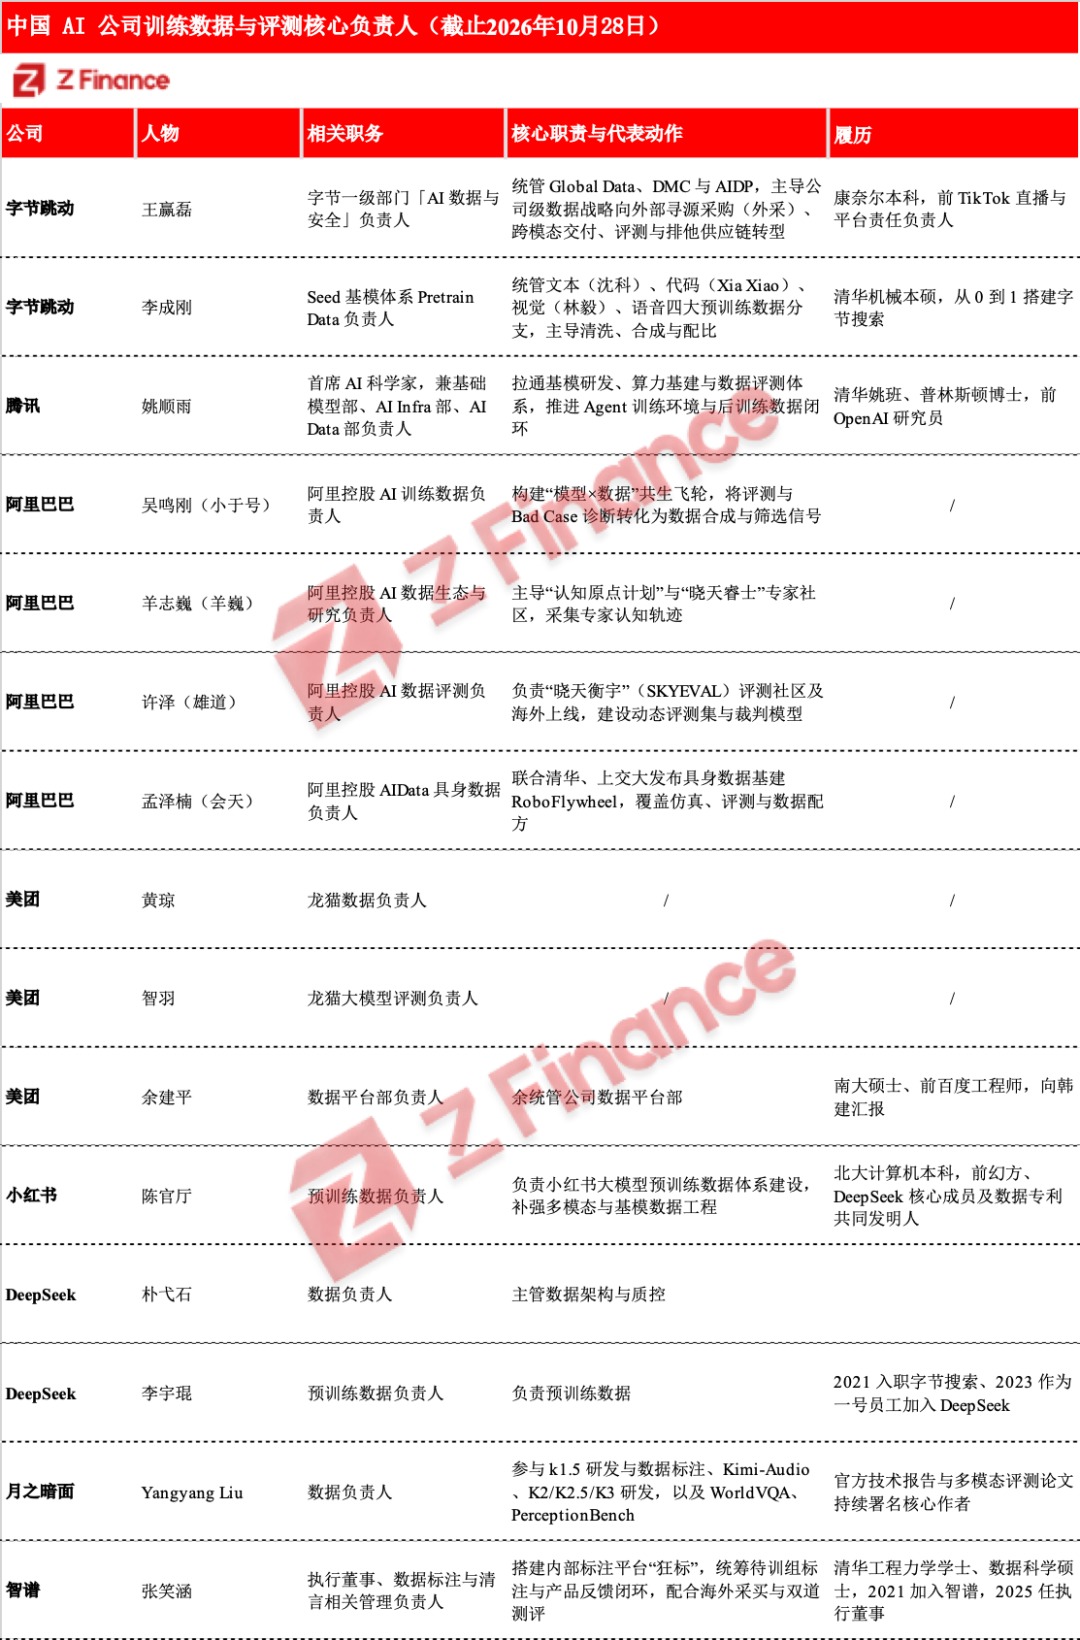
中国主流 AI 公司训练数据与评测核心负责人全景一览
注:本表根据公开信息整理,受信息披露范围与时效性限制,部分人员的职务、职责及履历可能存在偏差或变动,请以本人或所在机构的最新披露为准。如有疏漏,欢迎指正。
字节跳动:数据战略全面转向外采,公司级供应链与基模配方同步收拢
推荐算法时代,字节跳动是最不需要向外部买数据的公司。今日头条、抖音、TikTok 与豆包每天都在产生海量交互信号。但在过去一年半里,字节的 AI 数据战略发生了一次彻底转向:从依赖内部流量与自建基础标注,全面转向大规模、高溢价的外部采购与外部供应商整合。
逼迫字节转向外采的,是三堵同时撞上的高墙。第一是公域语料见顶,训练重心转向“私域过程数据”:全球约 300 万亿 Token 公开文本逼近枯竭,而公开网页只有最终报告,缺少医生、律师、程序员在真实工作流中“如何理解模糊意图、如何犯错并修正”的推演过程,这类数据只能向外部专家网络重金采买。
第二是内部数据回流(Dogfooding)在硬核赛道一度卡壳:在决定智能体上限的 Coding 赛道,由于早期 Doubao-Seed-Code 能力有限,字节内部业务团队都不愿用,连自家编程工具 TRAE 最早接入的也是 DeepSeek 和 Claude Code;内部飞轮转不起来,倒逼字节在 2026 年一面强制内部业务接入 Seed,一面拨出超千万美元预算在外部定向采购编程数据、拆解研究 Claude Code 与 Codex 的训练数据 demo,并与硅谷编程数据独角兽 Turing(估值 22 亿美元)及本土数据商合作。
第三是张一鸣“坚决不蒸馏”的铁律:2026 年 7 月底 Seed 全员会上,张一鸣明确表态“坚决不蒸馏竞争对手模型”,8 月初 CEO 梁汝波亦重申“坚定自研、接受短期落后”;与此同时,字节正在预训练参数规模达 5 万亿至 10 万亿的超大模型。堵死蒸馏捷径后,字节只能在全球市场上自己花钱买“教材”。
这让字节迅速成为国内出手最阔绰的头号外部数据买家,外采重点集中在四条主航道:
世界模型外采(投入达同行 3–4 倍):世界模型位列 2026 年字节 AI 四大命题之首,由张一鸣亲自督导跨部门调配算力,Seed 内合并李航与王文千的 VLA 团队、新设前 Meta FAIR 研究员范浩奇带队的 3D 仿真组,统一向周畅汇报,冲刺年底追平 Google Genie 3。字节批给世界模型(VLA、长视频、3D 资产)的数据预算居各模态之首,达数千万元至千万美元级且“不够可随时追加”,数据供应商透露其投入达到同行 3–4 倍;
Seedance 外采影视母带:针对视频生成喂入过多低质短视频会导致模型“偷懒”只学关键帧的“反缩放定律(Anti-Scaling Law)”,字节剥离低质快餐视频,转向外采高帧率影视工业正版母带,并组建了 1000 至 2000 人的评测与清洗军团(每位算法工程师背后配十余名数据人员);
垂类专家网络采买:早在 2025 年 3 月,字节采购部便公开寻源医疗、法律、教育等垂类标注供应商(合作法本信息、海天瑞声、曼孚科技等);2026 年除自营“字节 Xpert”众包入口外,更向时薪 100–400 元的国内硕博池、时薪 50–250 美元的海外专家平台及初创公司大举下单;
内部赛马算 ROI,外部签排他协议:字节数据团队内部按世界模型、代码、高难学科推行赛马机制,每个外采项目必须核算 ROI;对外则在合同中设定数据集独家买断期限或阶段性买断供应商核心人员,同时应对腾讯等对手近半年开出三倍薪资挖角字节数据骨干的攻势。
外采账单急剧膨胀,直接触发了 2026 年 8 月的组织大手术。此前,字节内部长出了多套各自买数据的班子:傅越 2023 年创立的 Global Data(约百人,设采购、工程、产品、质检等职能)、集团数据中台 DMC、Flow 下属 AIDP 以及抖音数据服务平台,多头询价导致架构重叠。
6 月启动整合、8 月 11 日正式揭牌,字节新设与 Seed、Flow、抖音平行的公司级一级部门“AI 数据与安全”,收拢上述所有团队,由王赢磊接棒离职的傅越,统管“标准制定、寻源采购、合成清洗、质量评测”全流程。
仅隔一周,Seed 基模内部同步重组,新设 Pretrain Data(李成刚)、Horizon RL(唐晟宇)、Product Posttrain-Work(秦禹嘉)和 Product Posttrain-Chat(朱文佳)四个部门,均向吴永辉汇报。 一外一内,分别掌管公司级数据供应链与基模内部训练配方。
王赢磊:TikTok 业务高管接棒傅越
王赢磊,图片来源:TikTok
不同于对手把数据交给算法科学家,字节连续两任公司级数据掌门人都出自 TikTok 业务与治理高管——上一任是傅越,这一任是王赢磊。
前任傅越(花名 Yuyi)是搭建字节早期数据外采与质检体系的人。她本科毕业于北大,拥有 MIT MBA 与哈佛 MPA 双硕士学位,曾任职于 BCG 与腾讯战略部,2018 年加入字节成为 TikTok 创始团队早期核心成员,主管信任与安全(T&S)及电商运营。2023 年 10 月重返字节后,她创立了专门配备数据采购与质检职能的 Global Data,为 Dola、TikTok 与 Seed 采买训练数据。2026 年 8 月交棒王赢磊后,傅越再次离职创业,于国庆前夕联手字节 TRAE 原负责人石扬切入 AI 办公赛道,首轮投后估值已达约 2 亿美元。
王赢磊的前任傅越(Yuyi),于 2023 年底至 2026 年 8 月创立 Global Data 并主导字节早期 AI 数据采购与安全体系建设。图片来源:凤凰网科技相关报道。
接棒的王赢磊同样是从 TikTok 海外战壕杀出来的 90 后高管。他本科毕业于康奈尔大学计算机科学与运筹学专业,早年任职于 Whisper 与 Snap。加入字节后,他在 TikTok 历经三段硬仗:早期在朱骏麾下搭建跨国「国家产品经理」团队并分管“内容画风”,2021 年初与谈斯奇、王率丁、增长负责人刘涵宇等共同构成朱文佳治下的核心班底;
2021 至 2025 年执掌 TikTok 全球直播四年,力排硅谷团队“买明星版权”的方案,在海外搭建起数万家外部公会招募、培训、PK 竞价与分账的人力供应链,助推 TikTok 成为首个累计内购破百亿美元的非游戏应用,汇报线一度直通周受资。2025 年 7 月底转任一级部门“平台责任”负责人(向支颖汇报),应对欧盟 DSA 与爱尔兰数据合规审查。
当字节的数据战略变成一场每年耗资数千万美元、横跨全球数十家外部供应商与上千人评测军团的工业消耗战,曾在 TikTok 直播管理过全球公会供应链的王赢磊,成了替字节筛选外部数据商、考核单项目 ROI 的最佳人选。
李成刚:从零搭建字节搜索,走向 Seed 的预训练数据中枢
李成刚。图片来源:字节跳动官方
王赢磊在外部掌管数据“兵站”,而在 Seed 内部决定模型“吃什么、怎么配比”的人是李成刚。李成刚为清华大学机械工程本硕,曾从 0 到 1 搭建字节网页与视频搜索系统;2023 年初字节启动语言大模型时便由搜索团队牵头,2024 年 5 月他以豆包预训练方向负责人身份公开亮相,主攻数据清洗、合成、配比与课程学习(Curriculum Learning)。
2026 年 8 月中旬,Seed 新设 Pretrain Data 一级部门,由李成刚负责并向吴永辉汇报,将分散在各模态的预训练数据收拢为四个分支:
文本分支:由 2018 年清华毕业加入字节、长期主抓超大模型预训练数据的沈科负责;
代码分支:由 Seed-Coder 与 BFS-prover 核心作者 Xia Xiao 负责,与 Horizon RL 负责人唐晟宇共管;
视觉分支:由林毅负责,与世界模型负责人周畅共管(Horizon RL 的视觉强化学习负责人吴侑彬在视觉方向上亦向林毅汇报);
语音分支:统筹音频与语音预训练语料。
这套交叉汇报设计直指全模态(Omni)与 10 万亿参数模型的痛点:当文本、代码、视觉、语音装进同一基座,单一模态数据的增减都会牵动全局能力,必须由 Pretrain Data 在同一实验框架下调配最优训练配方。
腾讯:首席科学家把模型、基建与数据拢于一炉
不同于字节“公司级外采供应链”与“基模预训练数据”分立的双轨制,腾讯在过去十个月里分三步把模型、算力与数据彻底收拢到了首席 AI 科学家姚顺雨一人麾下:
2025 年 12 月 17 日:前 OpenAI 研究员姚顺雨出任“CEO/总裁办公室”首席 AI 科学家(向刘炽平汇报),兼任大语言模型部与新设 AI Infra 部负责人(向卢山汇报,副总经理王迪向姚顺雨汇报);同日原数据平台部一分为二,专注大模型数据与评测的 AI Data 部由老将刘煜宏负责,数据计算平台部由陈鹏负责,均向蒋杰汇报;
2026 年 7 月:继 3 月撤销 AI Lab 后,腾讯将混元旗下的大语言模型部与多模态模型部合并为基础模型部,交由姚顺雨统管;
2026 年 9 月 28 日:姚顺雨正式兼任 AI Data 部负责人(向卢山汇报),刘煜宏卸任。至此,基础模型部、AI Infra 部、AI Data 部三大核心部门全部合拢于姚顺雨手中。
姚顺雨:把混元变成模型、环境与数据评测的一体化组织
姚顺雨。图片来源:本人主页。
1998 年出生的姚顺雨毕业于合肥一中(曾获 NOI 银牌),2015 年以安徽理科探花考入清华姚班,后获普林斯顿大学 CS 博士学位。在普林斯顿与 OpenAI 期间,他主导或参与了 ReAct、Tree of Thoughts(ToT)、SWE-bench、SWE-agent、τ-bench 以及第一代通用智能体 Operator 和 Deep Research 的研发。
姚顺雨为何要亲自接管数据部门,答案写在他 2025 年的博文 The Second Half 里:当强化学习训练配方趋于成熟,下半场真正拉开差距的不再是改模型结构,而是如何定义现实任务、构建可交互的训练环境与防刷榜的评测基准。
2026 年腾讯混元重建预训练与 RL 基建,从微信、腾讯会议、广告、游戏及 CodeBuddy 等超 50 个业务收集反馈,同时在外采市场上大幅追加预算、并跟投了估值 25 亿美元的 UniPat。由姚顺雨把模型、算力与数据一肩挑起,正是为了消灭部门墙,把“发现缺陷—外采或合成环境—修正训练”的反馈环压到最短。
刘煜宏:从腾讯实时大数据底座,到混元与 AI Data 的前任拓荒者
刘煜宏,CNCC 2019 嘉宾照片。图片来源:中国计算机学会会议官网。
在姚顺雨接手前,替腾讯完成数据团队向大模型转型的,是 2005 年入职的二十年老将刘煜宏。他早年负责腾讯实时数据平台 TDBank 与实时计算平台 TRC,历任数据平台部数据中心总监、腾讯大数据负责人及腾讯云数据产品线总经理;大模型浪潮兴起后,他以混元大模型负责人身份主导了万亿参数 MoE 模型训练与“腾讯元宝”早期迭代,并于 2025 年 12 月出任首任 AI Data 部负责人,完成了第一代大数据基建老将向 AI 时代的交接。
阿里巴巴:顶层重组之下,训练数据、专家生态、评测与具身数据四线分治
2026 年的阿里,呈现出了国内大厂中分工颗粒度最细的一套 AI 数据组织。在集团顶层,阿里今年先后成立由吴泳铭挂帅的 Alibaba Token Hub(ATH)事业群与集团技术委员会,将通义实验室升格为由周靖人执掌的通义大模型事业部(李飞飞管 AI 云基建、吴泽明管 AI 推理平台),6 月又整合成 Token Foundry。
而在数据层,早在 2025 年 9 月云栖大会上,淘宝早期个性化推荐核心骨干魏虎(花名:空望)便以阿里巴巴 AI 数据总经理身份首发“晓天衡宇”(SKYLENAGE)评测平台。到了 2026 年 9 月 23 日云栖大会,阿里控股 AI 数据体系下的四位细分掌舵人集体亮相:吴鸣刚(小于号)、羊志巍(羊巍)、许泽(雄道)、孟泽楠(会天),分别把守训练数据、专家生态、评测与具身数据四道关口。
吴鸣刚(小于号):AI 训练数据负责人,运转“模型×数据”共生飞轮
吴鸣刚在云栖大会相关论坛演讲。图片来源:魔搭 ModelScope 社区,Readance 收录。
阿里控股 AI 训练数据负责人吴鸣刚(小于号)的核心任务,是把数据从“一次性消耗品”变成可持续产能。他在云栖大会上拆解了一套由“模型→数据”与“数据→模型”两个半环咬合的共生飞轮,串联起人机协同合成、质量验证、训练信号反馈、知识库增强与 Bad Case 模式发现七个节点——不再只看语料库绝对体量,而是用评测暴露的能力短板和训练梯度信号,反向指挥下一轮数据的合成与配比。
羊志巍(羊巍):AI 数据生态与研究负责人,挖掘专家脑子里的“认知轨迹”
羊志巍在云栖大会相关论坛演讲。图片来源:魔搭 ModelScope 社区,Readance 收录。
阿里控股 AI 数据生态与研究负责人羊志巍(羊巍)主攻公开网页爬不到的专家隐性知识。他指出,模型的自我合成能力越强,越需要真实专家信号纠偏,否则极易陷入“合成数据坍缩”与“奖励欺骗(Reward Hacking)”;机器真正缺的不是标准答案,而是主任医师会诊或架构师排障时“提出假设—寻找证据—证伪推翻—纠偏回溯”的认知轨迹。
为此,他砍掉死板的标注表单,换上交互白板、推演沙盒与实时语音工具捕捉专家思考停顿,并启动“认知原点计划”,依托“晓天睿士”专家社区面向医学、先进制造、金融合规开放 1 万个专家协同席位。
许泽(雄道):AI 数据评测负责人,守住“量天之尺”防污染与防刷榜
阿里控股 AI 数据评测负责人许泽(雄道)手握决定研发预算投向的“量天之尺”。针对静态榜单易污染、易饱和的痛点,他推动评测走向真实任务交付——综合考核答案准确率、耗时、Token 成本与交互体验,结合代码沙盒验证、Agent 裁判模型与人类专家复核。
目前其团队已将 SKYEVAL 晓天衡宇评测社区推向海外上线,与阿里拟按 25 亿美元估值领投外部评测独角兽 UniPat 形成内外呼应,共同争夺模型商业化验收的标准制定权。
孟泽楠(会天):AI Data 具身数据负责人,用 RoboFlywheel 连通物理世界
孟泽楠在云栖大会演讲(舞台中央)。图片来源:魔搭 ModelScope 社区,Readance 收录。
阿里控股 AIData 具身数据负责人孟泽楠(会天)负责把数据管线伸向物理世界。针对机器人本体异构、真机采集昂贵的痛点,阿里联合清华、上交大发布了开放具身数据基础设施 RoboFlywheel,由孟泽楠拆解其四层底座:跨物理引擎仿真与统一资产底座、声明式评测 Harness、记录“数据—算子—训练—权重—评测”全链路的 Episode-native 数据配方框架(RoboFlywheel-Recipe),以及统一质检的开放数据集社区。
美团:公司数据平台部与龙猫的训练数据链路
看美团的数据版图,必须把公司级业务数据平台和自研基座模型龙猫(LongCat)拆成两条线:一条是 2024 年 12 月由“数据科学与平台部”升级而来的数据平台部,收拢本地生活业务数据工具研发,由老将余建平负责、向韩建汇报;另一条是已迭代出 1.6T 参数 MoE 基座模型、LongCat-Flash 及智能体平台 CatPaw 的 LongCat 研发团队,内部设有独立的预训练数据、Agentic 环境扩展与评测团队——官方招聘页已公开大模型评测负责人智羽,而作者掌握的采访线索则指向黄琼担任龙猫模型数据负责人。
黄琼:龙猫数据负责人
黄琼担任美团龙猫模型数据负责人。结合官方披露的评测团队负责人智羽及美团 2025–2026 年技术报告,LongCat 的数据打法聚焦在两端:一是在 LongCat-Flash 中设计面向智能体的两阶段预训练数据策略与多智能体轨迹合成;二是依托本地生活壁垒,连续开源了覆盖外卖、到店、酒旅 66 个工具的交互基准 VitaBench 1.0/2.0、竞赛级数学基准 AMO-Bench、通用推理基准 General 365、长程规划基准 MineExplorer 以及搜索校准基准 LoHoSearch。
余建平:执掌公司数据平台部的千亿级机器学习系统老将
余建平,QCon 北京 2019 嘉宾照片。图片来源:QCon 会议官网。
执掌公司级数据平台部的余建平则是搜广推工程老将。他 2011 年硕士毕业于南京大学计算机系,早年任职百度凤巢,加入美团后主导搭建了支撑搜索、推荐、广告的千亿级特征深度学习系统,打通离线、近线与在线全链路。2024 年 12 月升任数据平台部负责人,代表的是美团交易与搜广推的平台底座,在职责上区别于龙猫模型训练数据团队。
小红书:组织大重构后,挖来前 DeepSeek 早期成员陈官厅管预训练数据
2026 年 4 月 30 日,小红书启动十三年来最大规模的组织集权:丁玲(柯南)升任总裁统管业务与技术,夏侯任算法负责人;同时新设一级部门 Dots(整合大模型、AI Infra、工程与产品,直接向柯南汇报)与企业智能部(合并企业效率部与数据科学部)。7 月 9 日,小红书从外部引入前 DeepSeek 早期核心成员陈官厅,出任预训练数据负责人。
陈官厅:从北大、幻方与 DeepSeek 研发现场,到小红书预训练数据一号位
陈官厅本科毕业于北京大学计算机专业(2021 年进入幻方、2022 年毕业),历任幻方 AI 工程师、DeepSeek 研究员,作为早期核心成员参与了 DeepSeek-V2、V3 及 R1 的预训练数据研发。
小红书拥有极度稀缺的生活经验社区笔记(其团队还在后训练方向与复旦联合开源了 DR-Rubric,用深度研究的方式自动构建评分细则),引入陈官厅正是为了将碎片化的社区图文清洗、配比成能推高基模智力的预训练语料。
DeepSeek:数据负责人朴弋石,与“一号员工”李宇琨
据《晚点 LatePost》2026 年 4 月报道,DeepSeek 总人数不足 200 人,内部无层级墙,按模型结构、Infra 与数据三大模块紧密咬合;数据从训前方案讨论起便深度介入,梁文锋甚至让“一半的核心研究员”亲自参与数据清洗、合成与标注。梁文锋曾算过一笔账:国内与海外顶尖水平在模型结构上若有一倍差距、数据效率上再有一倍差距,“合起来就要多消耗 4 倍算力”。除转投小红书的陈官厅外,公开会议与媒体报道中至少浮现出两位 DeepSeek 数据核心人物:朴弋石与李宇琨。
朴弋石与李宇琨:数据负责人与字节搜索出身的首位员工
2025 年 9 月杭州全球开源创新峰会(GOSIM Hangzhou 2025)及同期 AI Vision Forum 官方名录,将朴弋石明确列为 “数据负责人,DeepSeek”,职责为负责大规模模型训练的数据架构与质量控制。
另一位核心人物李宇琨则是 DeepSeek 的首位员工:他 2021 年入职字节跳动搜索团队,2023 年在 DeepSeek 创立之初跳槽成为一号员工,核心负责 DeepSeek 预训练数据。两人的存在说明,即便在扁平的“全员标数据”文化下,DeepSeek 依然由深谙搜索引擎与数据工程的专人把守语料关口。
月之暗面:全员 Staff 扁平架构下的数据负责人 liuyangyang
月之暗面保持着约 500 人规模,内部不设传统职级,通用头衔统一为 staff,支撑团队从 k1.5、万亿参数 K2、K2.5 一路迭代至 2026 年 7 月登顶开源 SOTA 的旗舰模型 Kimi K3。但扁平头衔之下分工依然明确,Kimi 的实际数据负责人是 Yangyang Liu。
检索月之暗面 2025–2026 年官方论文,Yangyang Liu 的署名贯穿始终:在 2025 年 1 月 Kimi k1.5 报告附录 A 中,他同时位列 Research & Development 与 Data Annotation 双名单;随后连续参与 Kimi-Audio、Kimi K2 以及 2026 年的 K2.5 与 K3。
2026 年 1 月与 7 月,她又作为核心作者接连发布测量多模态原子世界知识的 WorldVQA 和诊断视觉感知边界的 PerceptionBench,印证了其在数据标注、多模态数据与评测上的核心角色。
智谱:搭建“狂标”平台的数据标注负责人,走进了上市公司董事会
2026 年 1 月登陆港交所的智谱,给数据负责人安排了一个特殊席位:主导搭建内部数据标注平台的年轻高管张笑涵,在 2025 年 3 月获委任为执行董事。
这一地位源于智谱过去一年的战略突围:2025 年 5 月智谱砍掉垂直小模型路线,押注推理、编程、智能体三合一的 GLM 4.5,一次性投入 15 万亿 Token 通用数据与 8 万亿 Token 专项数据(达同行 1.5 倍),随后凭 GLM 5、5.2、5.3 连续夺回开源 SOTA,2026 年 7 月 API ARR 冲上 10 亿美元。
张笑涵:从清华工程力学、数据科学,到主导狂标平台
张笑涵(左四)与智谱团队港交所上市合影。图片来源:智谱
招股书显示,张笑涵 2019 年本科毕业于清华工程力学系,2022 年获清华数据科学硕士学位;读研期间于 2021 年 10 月加入智谱,持续负责数据标注体系与“智谱清言”相关管理工作。据 36 氪披露,智谱 2024 年便在海外配置了数据采购团队,内部则由张笑涵主导搭建自研标注平台“狂标”:AI 院内语言组与多模态组轮训,待训组全员上“狂标”标数据;每版模型上线前须经 AI 院通用测评与交付团队真实客户场景双道测评,将前端清言的用户反馈与后端标注生产拧成闭环。
结语:数据负责人,正在成为手握模型方向盘的隐形决策者
过去,数据工作的起点往往是一张需求单。如今,随着公开语料的增量价值收窄,模型训练向推理、智能体和真实任务深入,需求本身也需要被重新定义。
模型究竟缺少知识、推理过程,还是与环境交互的经验?一次失败应该通过补充专家示范、构建合成任务,还是调整评测方式来解决?这些判断发生在数据生产之前,却直接影响后续的训练投入与研发方向。
这也是新一代数据公司的机会。新的供应商能否进入核心研发流程,取决于它能否帮助客户识别能力缺口,并证明交付的数据确实弥补了缺口。相应地,数据负责人的价值,也越来越体现在能否将模型研究、外部供给与效果验证连接起来。
因此,观察一家 AI 公司的技术路线,除了看它发布了什么模型,也值得看它正在寻找什么数据、招募什么专家、搭建什么环境,以及用什么标准判断进步。数据负责人正站在这些选择的交汇处:他们未必独自决定模型的未来,却正在更深入地参与定义它。
来源:凤凰网,原文链接:https://tech.ifeng.com/c/8xbrHxmwD1N